Luật sư tự chế máy chủ AI với 8 card V100 nâng cấp DeepSeek lên chuẩn gần NVFP4
Một luật sư tại Mỹ đã nâng cấp hệ thống AI cá nhân chạy bằng 8 card Nvidia V100 cũ của mình lên độ chính xác gần bằng NVFP4 cho DeepSeek V4.1 Flash. Bản độ mới giúp cải thiện độ trung thực của mô hình và cho phép xử lý song song nhiều tác vụ dù tốc độ sinh mã giảm nhẹ.
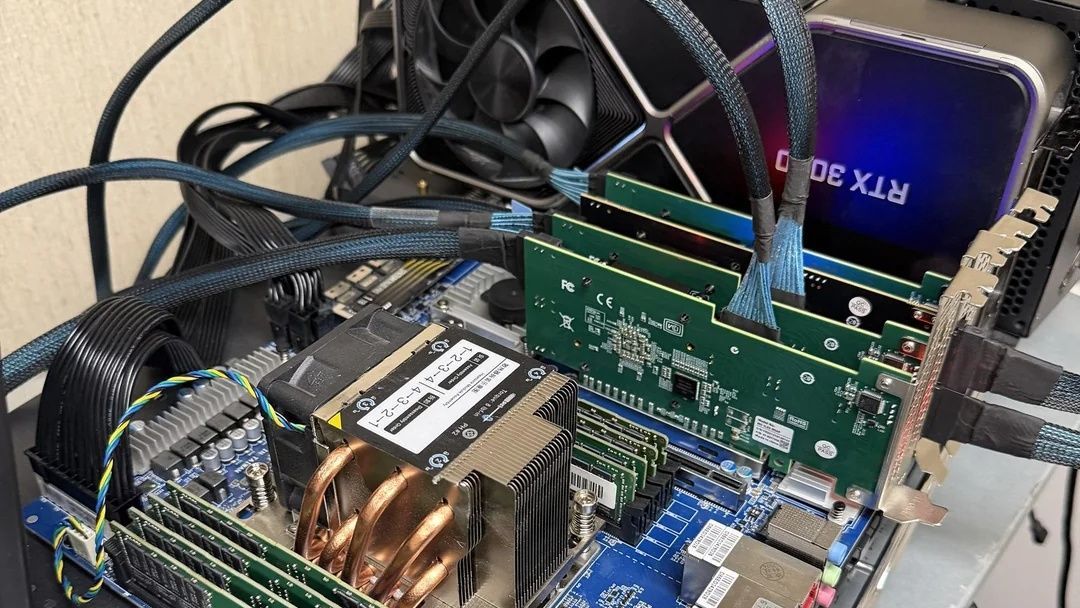
Một luật sư sở hữu máy chủ AI riêng tư được xây dựng từ tám GPU Nvidia V100 đã trở lại với một bản cập nhật mới, đưa khoảng 80% khối lượng công việc của hệ thống từ độ chính xác 2-bit lên chuẩn 4-bit NVFP4, đồng thời bổ sung 1TB RAM và một card RTX 3090. Máy chủ này đang chạy mô hình DeepSeek V4.1 Flash kết hợp với bộ công cụ pháp lý (legal harness) do chính anh tự phát triển và gói gọn các quy trình kiểm tra để phục vụ cho công việc hành nghề luật sư của mình. Cái giá phải trả là hiệu năng giảm sút, với tốc độ xuất mã nguồn giảm từ 160-215 xuống còn 150-180 token mỗi giây, bù lại các lỗi sập nguồn từng xuất hiện ở bản dựng trước đã biến mất. Thủ phạm gây ra các vụ sập nguồn ban đầu bịổ lỗi cho khe PCIe, nhưng thực chất có khả năng là do một bộ nguồn (PSU) bị hỏng.
Từng là một người dùng mạng xã hội Reddit đam mê phần cứng, những phản hồi của vị luật sư này trong bài viết gốc đã hé lộ danh tính của anh. Đó là Nick Mermiges, một luật sư tranh tụng tại Columbia, Nam Carolina. ProprietaryLegalAI đã bình luận dưới bài viết đầu tiên của chúng tôi ba lần, kèm theo liên kết đến kho lưu trữ mã nguồn, trang web và tài liệu LinkedIn xác định anh là nhà sáng lập PLI Labs và proprietarylegal.ai. Công ty còn lại của anh, PLI, là một công ty tư vấn công nghệ chứ không phải một hãng luật, và hiện cung cấp dịch vụ LLM riêng tư triển khai trực tiếp tại chỗ (on-prem).
Anh đã tự xây dựng phần mềm bằng sự trợ giúp của AI, cụ thể là Claude Code, công cụ đã viết các nhân (kernel) và chạy các bài kiểm tra chuẩn (benchmark) dưới sự chỉ đạo của anh. Các mô hình Opus 5.5 và Fable 5.2 đã xử lý các phần tối ưu hóa, nhân tùy chỉnh và lượng tử hóa lại; anh lưu ý bản thân rất bất ngờ trước việc Fable tạo ra các nhân Volta tùy chỉnh tốt đến thế, cũng như cách nó lượng tử hóa lại các chuyên gia mà bộ công cụ pháp lý của anh kích hoạt. Từ khoảng tháng 2 đến tháng 7, anh đã xây dựng một bộ công cụ pháp lý xoay quanh Claude và nó hoạt động hiệu quả, trong khi các nỗ lực tự dựng phiên bản mô hình chạy cục bộ trước đó đã thất bại. Tuy nhiên, khi DeepSeek V4.1 Flash ra mắt, anh đã có thể cổng hóa nó thành công, dù anh thừa nhận nó chưa thể sánh bằng các mô hình tiên tiến nhất (frontier model).
Anh tái khẳng định rằng “các tài liệu không bao giờ rời khỏi văn phòng” và đã nâng cấp hệ thống từ 256GB lên 1TB RAM, đồng thời gắn thêm một GPU đời mới hơn, dù các card V100 vẫn đang hoạt động trong “quỹ thời gian ít ỏi” với R580, nhánh trình điều khiển cuối cùng của Nvidia hỗ trợ chúng. Mục đích của dự án, như đã liệt kê lần trước, là giúp hệ thống có thể gánh bớt khối lượng công việc của anh, vì vậy đợt nâng cấp phần cứng và thay đổi độ chính xác này là hoàn toàn hợp lý. Mục tiêu từng được đề cập trước đó là muốn hệ thống xử lý nhiều yêu cầu cùng lúc cũng đã đạt được.
Bản dựng ban đầu mang tên “Volta sPLIt” nay đã lột xác thành “Volta Max uPLIft”, tiếp tục chơi chữ với tên viết tắt công ty của anh là PLI — Proprietary Legal Intelligence. Giờ đây, anh tuyên bố đạt được “độ chính xác gần bằng NVFP4”, sau khi mô tả NVFP4 trên diễn đàn của chúng tôi vào đầu tuần này là “về cơ bản là độ chính xác đầy đủ”. NVFP4 là định dạng dấu phẩy động 4-bit của Nvidia, và hãng cũng công bố phiên bản NVFP4 của riêng họ dành cho DeepSeek V4.1 Flash; tệp README của dự án cho biết phiên bản đó khớp với độ chính xác theo trọng số gốc của mô hình ở mức 4.25 bit cho mỗi trọng số.
DeepSeek V4.1 Flash được cấu thành từ các “chuyên gia” (expert), những phần của mô hình thực hiện phần lớn công việc cho mỗi từ. Mô hình này trước đây không thể vừa vặn ở độ chính xác đó, bởi vì 384 chuyên gia được định tuyến trong mỗi 47 lớp tổng cộng lên tới 15.360 chuyên gia. Theo ước tính của anh, ở độ chính xác chính thức, con số này đạt khoảng 269 GiB, trong khi tám card V100 dung lượng 32GB chỉ có tổng cộng 256 GiB trước khi nạp thêm bất cứ thứ gì khác. Ở bản dựng 2-bit, trọng số chiếm 248.8GB; còn gói Hugging Face của bản dựng mới lên tới khoảng 556GB.
Giải pháp thay thế là giữ mọi chuyên gia trên các card ở mức 2-bit và hoán đổi các chuyên gia được sử dụng nhiều nhất cho đến khi các card đầy, trong trường hợp này chiếm khoảng 38.7%, tương đương 5.949 chuyên gia, đạt chuẩn chính xác NVFP4. “Được sử dụng nhiều nhất” trong ngữ cảnh này đề cập đến số liệu thống kê từ sự kết hợp của bốn loại văn bản được trọng số đều nhau, trong đó có lưu lượng từ chính bộ công cụ pháp lý của anh.
Đổi lại, các chuyên gia đó gánh vác phần lớn công việc. Trong các bài kiểm tra chạy một yêu cầu tại một thời điểm, từ 80% đến 86% các tuyến giải mã — tức các lệnh gọi đến một chuyên gia khi mô hình viết — rơi vào các chuyên gia NVFP4, thấp nhất đối với văn bản thông thường và cao nhất đối với mã nguồn. Dự đoán cho thiết lập chạy hai yêu cầu cùng lúc của anh là từ 78% đến 85%. Từ 15% đến 22% số lệnh gọi còn lại vẫn sẽ đi đến các chuyên gia 2-bit.
So sánh với phiên bản mô hình của chính Nvidia làm chuẩn tham chiếu, anh đã đạt được những kết quả khả quan. Tỷ lệ trùng token tiếp theo (cùng một token tiếp theo mà bản dựng chọn so với tham chiếu) đã tăng từ 92.2% lên 95.1%. Đối với độ phân kỳ KL (KL divergence, đo lường khoảng cách xác suất của bản dựng so với tham chiếu), con số này giảm xuống còn 0.079 nats từ mức 0.196. Khi đo lường các câu trả lời trắc nghiệm có thay đổi trên 513 câu hỏi từ một bài kiểm tra kiến thức trắc nghiệm tiêu chuẩn, số lượng câu trả lời khác biệt giảm từ 79 xuống chỉ còn 8.
Điều này không đo lường độ chính xác — vốn tương đương ở cả ba trường hợp — mà đo lường độ trung thực (fidelity). Các bài kiểm tra đó chạy trên bản phát hành đầu tiên của bản dựng, chứ không phải trên thiết lập hai yêu cầu mới mà anh đang vận hành.
Kết quả của các thay đổi mang lại độ trung thực cao hơn nhưng đổi lại hiệu năng thấp hơn. Tốc độ xuất mã nguồn chậm hơn từ 3% đến 30% tùy theo độ dài câu lệnh (prompt), và văn bản pháp lý chậm hơn từ 9% đến 23%. Trước khi thực hiện bản dựng, anh hy vọng duy trì khoảng 80 token mỗi giây cho văn bản pháp lý và văn xuôi; kết quả thực tế đạt từ 86 đến 106 cho pháp lý và 78 đến 86 cho văn xuôi. Điểm cộng là việc chạy hai yêu cầu cùng lúc giúp nâng tổng tốc độ xuất dữ liệu lên 159.0 token mỗi giây, so với 118.9 token khi chỉ chạy một yêu cầu duy nhất. Token đầu tiên cũng xuất hiện sớm hơn ở mọi độ dài câu lệnh, đạt 108.4 giây so với 118.7 giây ở mức 256K token.
Tuy nhiên, mỗi yêu cầu cần một “khe” (slot), và điều này đi kèm với cái giá phải trả. Mỗi slot duy trì trạng thái riêng trên các card, làm giảm không gian dành cho các chuyên gia NVFP4 xuống còn lần lượt là 6.215, 5.949 và 5.663 cho một, hai và ba slot. Điều này có nghĩa là mỗi slot bổ sung có thể đẩy thêm một đến hai phần trăm số lệnh gọi quay trở lại mức 2-bit, từ đó làm giảm chất lượng đầu ra.
So sánh hiệu năng DeepSeek V4.1 Flash trên tám card Tesla V100
Độ dài câu lệnh | Thời gian chờ token đầu tiên (2-bit / gần-NVFP4) | Mã nguồn (token/giây, 2-bit / gần-NVFP4) | Văn bản pháp lý (token/giây, 2-bit / gần-NVFP4)
--- | --- | --- | ---
1K token | 1.2 / 1.0 giây | 215.0 / 150.1 | 117.6 / 105.5
32K token | 17.2 / 16.0 giây | 200.5 / 165.1 | 116.5 / 93.4
128K token | 59.2 / 54.3 giây | 182.8 / 151.4 | 110.9 / 87.3
256K token | 118.7 / 108.4 giây | 160.0 / 154.6 | 103.1 / 93.5
Đo lường của nhà phát triển vào ngày 5 tháng 11 (2-bit) và ngày 12 tháng 11 (gần-NVFP4); giải mã tham lam (greedy decoding), tắt tính năng suy luận sâu (thinking off), chạy từng yêu cầu một.
Việc nâng cấp RAM diễn ra trong tuần này với tám mô-đun 128GB chạy ở tốc độ 2.933 MT/s, thay thế cho tám mô-đun 32GB ban đầu vốn phải chạy ở chuẩn DDR4-2666 do lỗi ECC. Sau khi nâng cấp RAM, hệ thống ghi nhận hai nút NUMA, và hai lần khởi động bị treo ở quá trình truyền dữ liệu đầu tiên giữa các bo mạch, buộc anh phải sắp xếp lại thứ tự các card bằng phần mềm. Các GPU vẫn bị giới hạn ở xung nhịp 1.522 MHz như trước.
Về vấn đề bộ nguồn (PSU), anh đã áp dụng cách tiếp cận thông thường là kiểm tra lần lượt các khe PCIe, card và cáp để thu hẹp nguyên nhân, cuối cùng kết luận “có lẽ là do một bộ nguồn bị hỏng”. Anh cũng gắn thêm quạt tản nhiệt, nhưng nhiệt độ không thay đổi cho thấy luồng gió không phải là vấn đề. Sau khi thay thế linh kiện cấp nguồn, chín trên chín phiên trò chuyện dài đều hoạt động trơn tru. Ngoài ra, đừng phán xét kỹ năng quản lý cáp của anh ấy; mọi “lời khuyên [về việc đó] đều được hoan nghênh nhưng sẽ bị phớt lờ”, đó là bình luận duy nhất phù hợp trong hoàn cảnh này.
Anh hiện cũng đang vận hành hai hệ thống DGX Spark chạy cùng mô hình ở ngữ cảnh 1M cho công tác tác vụ tự động (agent), xử lý ba đến four phiên cùng lúc, và anh chưa có ý định dừng lại ở đó. Bước tiếp theo là mở rộng quy mô. Thêm tám card V100 và một máy chủ thứ hai, trang bị 512GB RAM ECC tốc độ 3.200 MT/s đang chờ sẵn để đưa vào hoạt động. Hộp thứ hai này sẽ chạy một phiên bản DeepSeek có độ chính xác cao khác, đóng vai trò như một agent bổ sung hoặc thực hiện các tác vụ song song. Kế hoạch sắp tới cũng bao gồm việc chuyển mô hình dự thảo nhỏ của DeepSeek ra khỏi các card V100 sang card RTX 3090, dù việc này chưa được thực hiện.
Nguồn: Tom's Hardware · Bản dịch tiếng Việt của VGSNews, chỉ để tham khảo.