Google bổ sung dòng chip TPU thế hệ thứ 8 với TPU 8tx bảo mật cao và TPU 8i Max chuyên xử lý tác vụ dài
Google vừa mở rộng dòng chip TPU thế hệ thứ 8 bằng hai phiên bản chuyên dụng mới gồm TPU 8tx tập trung vào bảo mật cho doanh nghiệp lớn và TPU 8i Max tối ưu cho các tác vụ AI có ngữ cảnh siêu dài. Cách tiếp cận mô-đun này cho phép hãng ra mắt các hệ thống phần cứng chuyên biệt chỉ trong vài tháng thay vì nhiều năm.
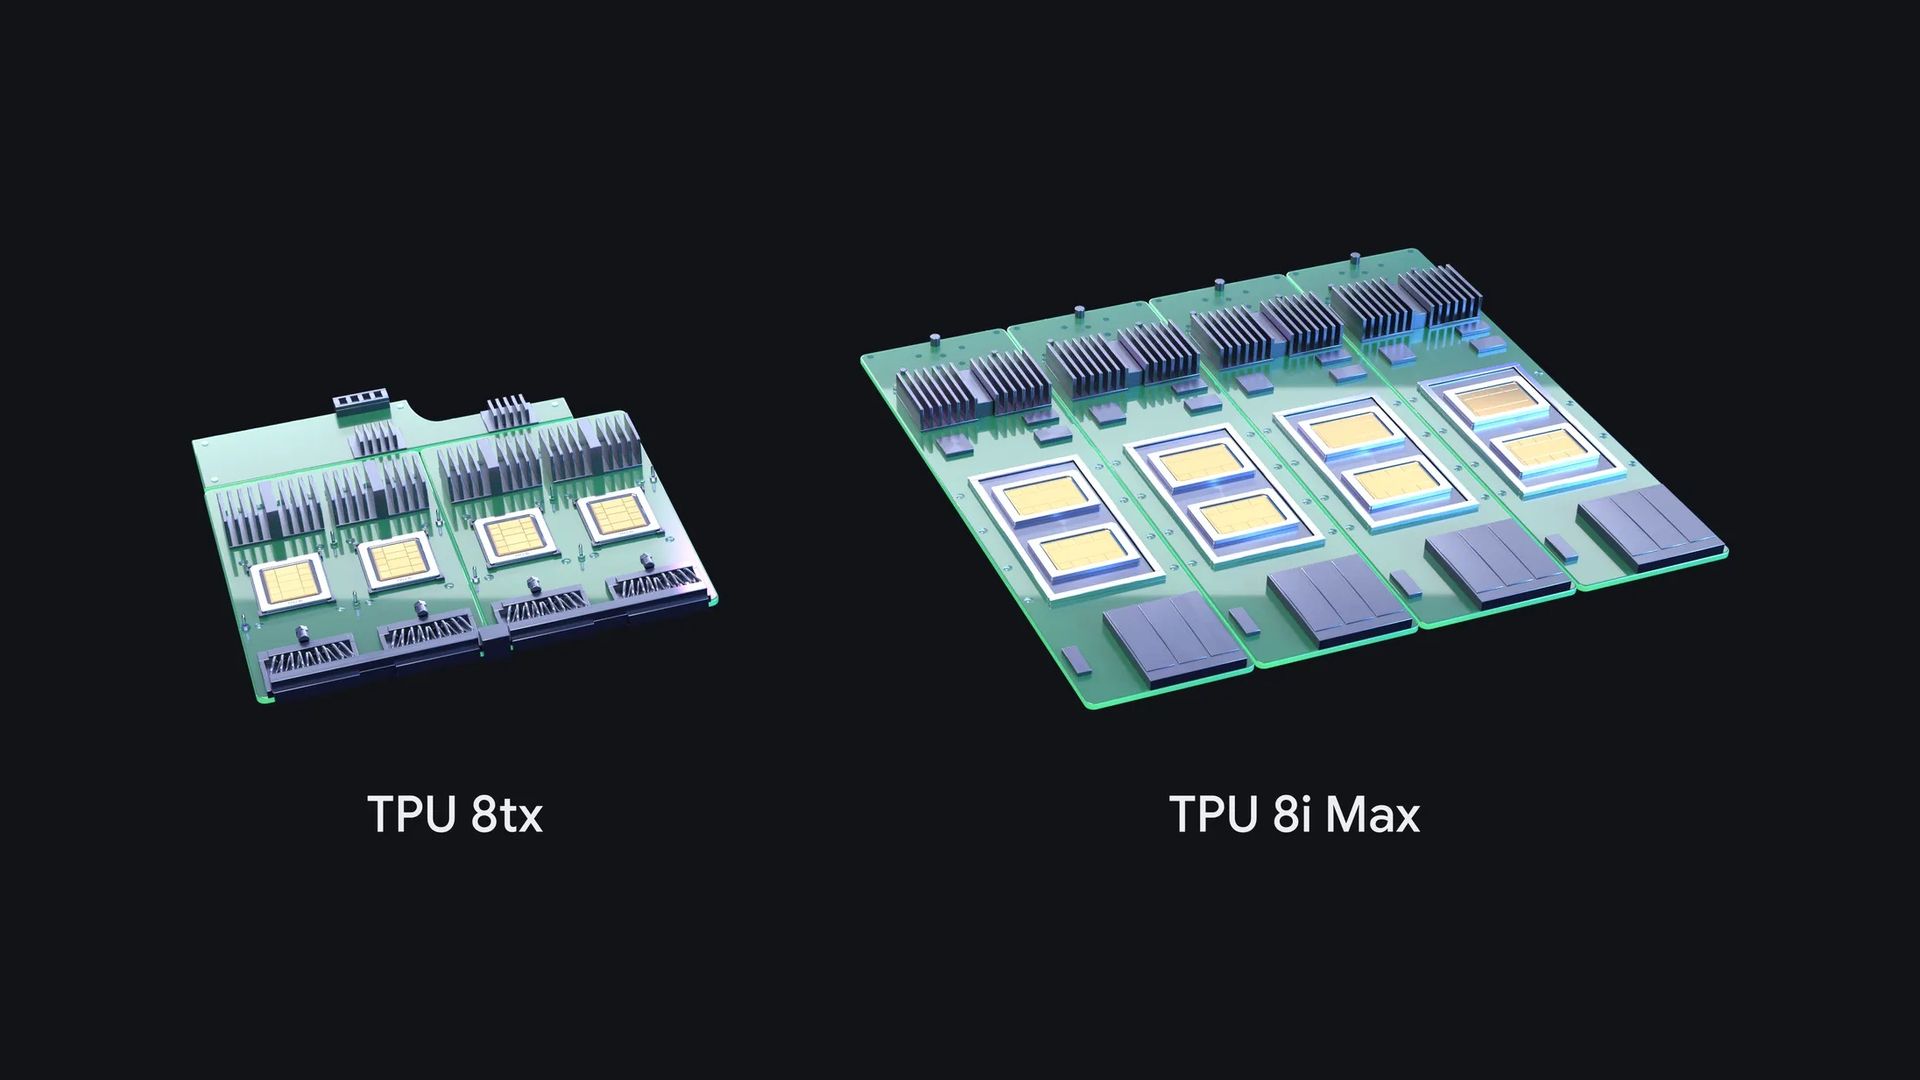
Dòng TPU thế hệ thứ 8 của Google tiếp tục được mở rộng. Hồi tháng 4, hãng đã công bố TPU 8t dành cho việc huấn luyện mô hình AI và TPU 8i cho các tác vụ suy luận đa mục đích. Giờ đây, Google giới thiệu TPU 8tx — được xây dựng trên cùng nền tảng silicon với 8t nhưng hướng đến việc suy luận bảo mật, cách ly bằng phần cứng cho các doanh nghiệp chịu quản lý chặt chẽ và chính phủ — cùng với TPU 8i Max kết hợp hai chip 8i trên một gói để xử lý các tác vụ agent AI có ngữ cảnh dài.
TPU 8tx thay thế các host Arm Axion của dòng 8t và 8i bằng CPU AMD EPYC thế hệ thứ 5, áp dụng mạng Boardfly, trong khi TPU 8i Max nhân đôi khả năng tính toán, dung lượng SRAM và băng thông HBM so với chiếc 8i gốc. Sự phân chia ban đầu gồm TPU 8t và 8i hoàn toàn hợp lý khi 8t nhắm đến việc huấn luyện quy mô lớn, còn 8i thiên về suy luận và lý luận độ trễ thấp. TPU đã trở thành mảng kinh doanh tăng trưởng nhanh với gần 100 khách hàng, bao gồm cả việc Meta gần đây chuyển sang sử dụng TPU. Cách tiếp cận mô-đun linh hoạt hơn này có thể cung cấp các hệ thống chuyên biệt "trong vòng vài tháng thay vì vài năm," giúp thúc đẩy mức độ phổ biến của chúng.
| Hệ thống TPU thế hệ 8 | TPU 8t | TPU 8i | TPU 8tx | TPU 8i Max |
|---|---|---|---|---|
| Xây dựng cho | Tiền huấn luyện quy mô lớn | Lấy mẫu, phục vụ và lý luận | Suy luận bảo mật, kín đáo; huấn luyện quy mô nhỏ | Công việc agent AI ngữ cảnh dài |
| Silicon | TPU 8t | TPU 8i | Cùng silicon với TPU 8t | Hai chip TPU 8i trên một gói |
| CPU chủ | Arm Axion | Arm Axion | AMD EPYC thế hệ thứ 5 | Chưa công bố |
| Mạng | 3D torus | Boardfly | Boardfly | Chưa công bố |
| FP4 PFLOPS đỉnh | 12.6 | 10.1 | Chưa công bố | Khoảng 20.2 (suy luận) |
| Băng thông HBM (GB/s) | 6,528 | 8,601 | Chưa công bố | Khoảng 17,202 (suy luận) |
| Dung lượng HBM (GB) | 216 | 288 | Chưa công bố | Chưa công bố |
| SRAM trên chip (MB) | 128 | 384 | Chưa công bố | 768 (suy luận) |
| Khả năng có sẵn | Sắp ra mắt | Sắp ra mắt | Sắp ra mắt | Sắp ra mắt |
Đối với các dòng sản phẩm mới, thoạt nhìn TPU 8i Max không quá đổi mới vì nó chỉ là sự kết hợp của hai chip TPU 8i vào một gói đơn lẻ. Kết quả là năng lực tính toán lý thuyết tăng gấp đôi, nhưng quan trọng hơn là nó chứa lượng silicon gấp đôi trong "diện tích rack hiện có", và Google tuyên bố mang lại nhiều hiệu năng tính toán hơn trên mỗi foot vuông cũng như mỗi watt điện.
Việc nhân đôi cả SRAM lẫn băng thông HBM giúp duy trì khả năng mở rộng, đưa 8i Max đạt khoảng 20.2 FP4 PFLOPS, 768 MB SRAM và khoảng 17.2 TB/s băng thông HBM. Con số này có thể so sánh với GPU Rubin R200 của Nvidia ở mức định mức 50 FP4 PFLOPS cho suy luận và 22 TB/s HBM4 cho mỗi socket, hay MI455X của AMD với 40 FP4 PFLOPS. Khoảng cách về năng lực tính toán đang dần được thu hẹp.
Việc nhân đôi băng thông bộ nhớ cũng là một cách tiềm năng để vượt qua việc phải chuyển sang HBM4. Bức tường bộ nhớ (memory wall), theo cách gọi của Google, hay nút thắt cổ chai băng thông, là mối lo ngại thực sự "khi hàng chục agent AI làm việc cùng nhau trên toàn bộ cơ sở mã phần mềm". Các cửa sổ ngữ cảnh lớn hơn — với các mô hình lớn nhắm đến 1 triệu token — đồng nghĩa với bộ nhớ đệm KV lớn hơn, được lưu một phần trong SRAM, và mỗi token mới phải đọc lại bộ nhớ đệm đó từ bộ nhớ chính, đó là lúc băng thông HBM bổ sung phát huy tác dụng. Đây là một hướng đi khác biệt so với LPX của Nvidia: nhiều băng thông hơn trong một gói duy nhất, thay vì loại chip thứ hai dành cho việc giải mã và tầng lưu trữ cho ngữ cảnh.
Google cũng cung cấp phần mềm hữu ích cho các agent để tận dụng tối đa phần cứng của mình. TPU Sync là một lớp trạng thái mô hình mã nguồn mở dành cho các cụm TPU, giúp chuyển các bộ nhớ đệm KV ra khỏi HBM của chip, "tự động phân tầng các bộ nhớ đệm KV lớn ra khỏi chip trong vài mili giây" xuống DRAM của host và, theo dạng thử nghiệm, xuống bộ nhớ chia sẻ. Google cho biết điều này có thể cắt giảm độ trễ truyền tải KV "hơn 90%", với thời gian tạo token đầu tiên cải thiện tùy theo khối lượng công việc. Hãng cũng công bố Agent Compute Engine, một dịch vụ Google Cloud tạm dừng các phiên agent nhàn rỗi và di chuyển bộ nhớ làm việc của chúng sang một bên cho đến khi cần dùng lại, một nỗ lực tiết kiệm bộ nhớ khác.
Google ghi nhận ngăn xếp vLLM-TorchTPU của họ đạt "các mốc hiệu năng trên giá thành tối tân" trên InferenceX và AgentX, các bài kiểm tra mã hóa tác vụ agent thực tế và công việc ngữ cảnh dài. Tuy nhiên, các con số bên thứ ba được công bố cho đến nay chỉ dành cho dòng Ironwood TPU thế hệ trước. Trong các bài kiểm tra InferenceX của SemiAnalysis vào tháng 9, khi chạy Qwen3.5 397B ở định dạng FP8, Ironwood mang lại nhiều hơn 50.4% token trên mỗi đô la so với B200 của Nvidia và nhiều hơn 96.0% so với B300 ở mức 20 token mỗi giây cho mỗi người dùng. Tuy nhiên, một vấn đề là Ironwood thiếu định dạng FP4 gốc, mặc dù các kết quả mới hơn vào tháng 11 cho thấy định dạng FP8 của nó đánh bại GB300 NVL72 FP4 của Nvidia trên cùng một mô hình, đạt hiệu năng trên mỗi đô la gấp 1.67 lần. Hiện cũng chưa có kết quả từ thế hệ thứ 8 để so sánh sự khác biệt của thế hệ mới.
Trái ngược với 8i Max được thiết kế cho các công việc ngữ cảnh dài, TPU 8tx mới, "được xây dựng trên cùng silicon với TPU 8t", được "tối ưu hóa cho việc suy luận bảo mật và kín đáo" cũng như huấn luyện quy mô nhỏ. Tính bảo mật được tích hợp thẳng vào phần cứng với khả năng cách ly nhằm ngăn chặn việc theo dõi dữ liệu nhạy cảm, bao gồm cả trọng số của mô hình. Thông thường, dữ liệu phải được giải mở khóa trong bộ nhớ trong quá trình xử lý, đây chính là bước mà tính năng cách ly này nhắm tới để che giấu.
Con chip này hướng tới các lĩnh vực mà tính bảo mật và kín đáo được đặt lên hàng đầu, nghĩa là các doanh nghiệp chịu quản lý và chính phủ, đặc biệt là những bên đang sử dụng các mô hình tiên tiến hoặc độc quyền. Trong trường hợp đó, các nhà vận hành có thể muốn "tinh chỉnh mô hình bằng dữ liệu riêng tư của họ, chắt lọc các mô hình lớn thành các mô hình nhỏ hơn, và huấn luyện các agent của mình," mà không phải di chuyển dữ liệu nhạy cảm giữa các cụm. Agent và tính bảo mật gặp nhau tại đây để tạo ra "quá trình thực thi agent an toàn". Hồi tháng 4, Lầu Năm Góc và Google được cho là đã tổ chức các cuộc thảo luận về việc sử dụng TPU trong các thiết lập phân loại, mặc dù con chip 8tx không được gọi tên cụ thể.
Private AI Compute của Google, nền tảng TPU được gia cố với các biện pháp bảo vệ "có thể so sánh với TEE thông thường", theo bản tóm tắt kỹ thuật hồi tháng 9 của họ, đã chạy dịch vụ bảo mật trên TPU. 8tx có vẻ là khả năng đó được thương mại hóa thành sản phẩm dành cho khách hàng. Các giải pháp thay thế bao gồm NVL72 của Nvidia với một miền bảo mật trải dài trên 72 GPU Rubin, 36 CPU Vera và các kết nối liên thông, cùng với TDX của Intel đang bổ sung I/O đáng tin cậy để bao phủ dữ liệu di chuyển đến các bộ gia tốc.
Các host của 8tx dựa trên bo mạch AMD EPYC thế hệ thứ 5, thay vì các host Axion trên dòng 8t vốn đã thay thế x86 vào tháng 4. Có một chip Axion cho mỗi hai TPU trên 8i, so với một chip Xeon cho mỗi bốn TPU trên Ironwood. Google không đưa ra lý do cho sự thay đổi này, nhưng danh sách cấu hình Máy ảo Bảo mật (Confidential VM) của họ có cả dòng chip AMD và Intel, không có dòng nào dựa trên kiến trúc Arm. Private AI Compute sử dụng "Môi trường Thực thi Tin cậy dựa trên phần cứng của AMD" cho các khối lượng công việc CPU của mình, cho thấy Google đã thay thế một thứ mà họ đã chạy sẵn trên ngăn xếp bảo mật của mình.
8tx cũng áp dụng mạng Boardfly của dòng 8i thay vì mạng torus của 8t, mà Google tuyên bố có thể mang lại "độ trễ thấp hơn tới 2 lần so với TPU 8t" với hầu như không có tổn thất hiệu năng, mặc dù chưa rõ Google đang sử dụng thước đo nào. Mạng torus thay thế phù hợp cho việc huấn luyện, vì các chip chủ yếu trao đổi dữ liệu với các hàng xóm theo cách có thể dự đoán trước, nhưng việc suy luận trên các mô hình hỗn hợp chuyên gia (Mixture-of-Experts) lớn và các mô hình lý luận có thể gửi các thông điệp nhỏ hơn giữa các chip ở xa, với mỗi bước nhảy (hop) lại làm tăng thêm độ trễ. Với Boardfly, số bước nhảy tối đa là 7 so với 16 ở cụm 1,024 chip.
Điều còn thiếu là một bảng thông số kỹ thuật đầy đủ, dung lượng bộ nhớ HBM, kích thước pod, ngày có sẵn, giá cả và khách hàng cho cả hai hệ thống. Các chi tiết về việc chứng thực (attestation) — tức là khả năng khách hàng xác minh tính bảo mật — cũng còn thiếu đối với 8tx. Cả 8tx và 8i Max hiện được liệt kê cùng với 8i và 8t dưới trạng thái "sắp ra mắt" trên trang Cloud TPU của Google.
Việc tung ra hai hệ thống TPU mới gần bảy tháng sau cặp đôi hồi tháng 4 cho thấy Google muốn sản xuất các hệ thống chuyên biệt nhanh hơn nhiều so với trước đây. Giờ đây, họ chỉ cần chứng minh chúng thông qua các bài benchmark và thời điểm phát hành thực tế khi phần cứng đến tay khách hàng.
Nguồn: Tom's Hardware · Bản dịch tiếng Việt của VGSNews, chỉ để tham khảo.