Luật sư tự chế máy chủ AI bằng 8 GPU Nvidia V100 cũ để bảo mật tài liệu
Một luật sư đã tự lắp ráp máy chủ AI riêng tư sử dụng 8 card đồ họa Nvidia Tesla V100 cũ đời 2018 nhằm đảm bảo tài liệu vụ án không phải đưa lên đám mây. Hệ thống chạy mô hình DeepSeek V4.1 Flash, đạt tốc độ lên tới 215 token mỗi giây và xử lý được khoảng 50-60% khối lượng công việc LLM hàng ngày.
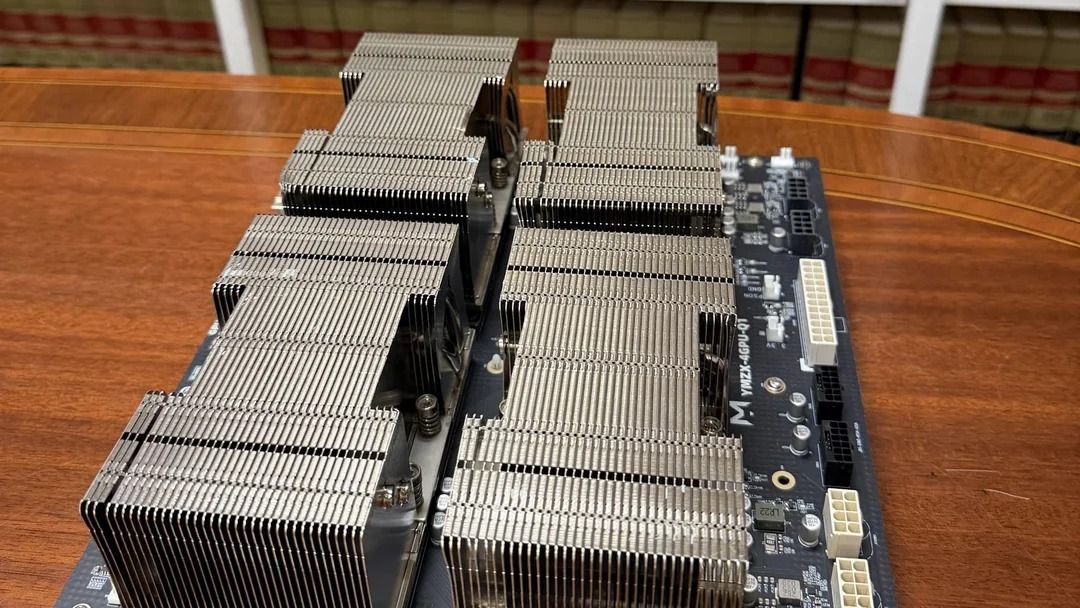
Một luật sư đã đăng tải lên Reddit về việc tự xây dựng một máy chủ AI riêng tư từ tám GPU trung tâm dữ liệu Nvidia Tesla V100 cũ đời 2018, đảm bảo hồ sơ vụ án không bao giờ phải rời khỏi văn phòng. Với hai bo mạch SXM2 NVLink 4 card, bốn switch PEX và cáp SlimSAS chằng chịt khắp nơi — cùng một đầu cấp nguồn bị cháy — người chế tạo hiện đang chạy mô hình mở DeepSeek V4.1 Flash với mọi chuyên gia nằm trong bộ nhớ GPU, đạt tốc độ lên tới 215 token mỗi giây. Các bo mạch bốn GPU có giá khoảng 2.400 USD mỗi chiếc khi được mua.
Tám chiếc card Tesla V100-SXM2-32GB, mỗi chiếc có 32GB HBM2 tốc độ 900 GB/s, cắm vào SXM2 (socket mezzanine của Nvidia dành cho GPU trung tâm dữ liệu) thay vì các khe PCIe, và được chia đều trên hai bo mạch chủ. Bên trong mỗi bo mạch, cả bốn card đều được liên kết qua NVLink (kết nối GPU-với-GPU trực tiếp của Nvidia) để đạt 128GB mỗi bo mạch, nhưng hai bo mạch chỉ giao tiếp qua PCIe. Mỗi bo mạch kết nối với máy chủ thông qua hai card switch PEX (PLX) qua cáp SlimSAS (tổng cộng bốn switch), với mỗi switch xử lý hai GPU ở tốc độ PCIe 3.0 x8 qua đường uplink x16 riêng.
Tuy nhiên, mức giá đưa ra đã thuộc về quá khứ: các card V100 SXM2 32GB cũ hiện được niêm yết trên eBay với giá khoảng 900 USD, cao gấp đôi mức khoảng 400 USD mỗi chiếc trong bài đăng, và các bài đăng cho thấy giá vẫn đang tiếp tục tăng. Hệ thống này cũng đã có sẵn một số linh kiện cần thiết khác: bo mạch chủ Gigabyte Threadripper Pro với CPU 3945WX 12 nhân tương ứng, 8 thanh DDR4 RDIMM 32GB, một node NUMA và hai nguồn điện tổng cộng 2.800W dùng các ổ cắm điện văn phòng thông thường riêng biệt. Đây là một trường hợp thực tế cho thấy việc sử dụng phần cứng trung tâm dữ liệu cũ là một con đường giá rẻ để gom nhiều VRAM tốc độ cao về một chỗ.
Máy chủ hiện đang được sử dụng hàng ngày cho công việc xử lý bước đầu hồ sơ vụ án: đọc một thư mục tài liệu, trích xuất sự kiện, ngày tháng, con số, tóm tắt chúng và thực hiện bước soạn thảo thông thường đầu tiên. "Không có gì lọt ra ngoài mà không được đánh giá thực tế", đây là một chính sách con người trong vòng lặp (human-in-the-loop) tốt nói chung. Nó cũng giúp đảm bảo quyền riêng tư cho các trường hợp tệp khách hàng không thể gửi lên đám mây hoặc các mô hình biên. Cơ sở dữ liệu RAG và gọi công cụ được tích hợp sẵn; người vận hành có thể điều khiển hệ thống thông qua giao diện kiểu Discord qua SSH, trong trường hợp này là từ một PC chạy Windows. Hiện tại, máy chủ chỉ xử lý một yêu cầu tại một thời điểm.
DeepSeek V4.1 Flash được nén chủ yếu về 2 bit ở đây, và trọng số của nó vẫn tổng cộng là 248,8GB. Các "chuyên gia" của mô hình, những phần làm phần lớn công việc cho mỗi từ, nằm hoàn toàn trong bộ nhớ GPU, trong khi khoảng 110GB bảng tra cứu (gọi là bảng Engram) nằm trong RAM thông thường của hệ thống. Việc truy xuất từ RAM tốn khoảng 0,12 mili giây mỗi bước, điều mà người chế tạo cho biết hầu như không ảnh hưởng đến các con số tốc độ.
Nửa đầu các lớp của mô hình (0–19) chạy trên bo mạch SXM2 thứ nhất và nửa sau (20–39) trên bo mạch thứ hai. Mỗi bo mạch xử lý lưu lượng nặng của nó qua NVLink riêng, vì vậy chỉ cần một lần chuyển giao mỗi bước qua liên kết PCIe chậm hơn giữa các bo mạch. Trong một bài đăng trước đó, người chế tạo nhận thấy rằng việc chia nhỏ mọi lớp trên cả tám card khiến tốc độ "rơi xuống vực thẳm" do bước nhảy PCIe đó.
Hiệu năng thực sự đáng kinh ngạc đối với một mô hình kích thước này. Code được tạo ra nhanh nhất, lên tới 215 token mỗi giây, bởi vì một mô hình nháp nhỏ được tích hợp sẵn trong DeepSeek dự đoán trước năm token, và code thì rất dễ đoán. Văn viết pháp lý, mục đích chính của máy chủ này, chạy ở tốc độ lên tới 118 token mỗi giây.
Các tài liệu dài mất nhiều thời gian hơn để khởi động: mô hình đọc các câu lệnh (prompt) ở mức khoảng 2.200 token mỗi giây, do đó ở mức 128K token, token đầu tiên xuất hiện sau khoảng một phút. Hệ thống có thể chấp nhận ngữ cảnh lên tới 524K token. Ba ngày trước bài đăng, cùng mô hình đó chạy trên bốn card chỉ đạt 36–38 token mỗi giây. Sự bứt phá đến từ bo mạch thứ hai (có khả năng nhân đôi hiệu năng trong điều kiện lý tưởng) và người chế tạo ghi nhận phần còn lại là nhờ các kernel tùy chỉnh và công việc tiền nạp (prefill). Xem bảng để biết chi tiết đầy đủ.
DeepSeek V4.1 Flash trên tám card Tesla V100:
- 1K token: Chờ token đầu tiên 1.2 giây | Code 215 token/s | Văn bản pháp lý 118 token/s
- 32K token: Chờ token đầu tiên 17.2 giây | Code 200 token/s | Văn bản pháp lý 117 token/s
- 128K token: Chờ token đầu tiên 59.2 giây | Code 183 token/s | Văn bản pháp lý 111 token/s
- 256K token: Chờ token đầu tiên 118.7 giây | Code 160 token/s | Văn bản pháp lý 103 token/s
(Đo đạc của người chế tạo ngày 5 tháng 11; giải mã tham lam (greedy decoding), đầu ra 1.024 token, trung bình của hai lần chạy).
Mọi chuyện không đơn giản chỉ là cắm mọi thứ lại và bật nguồn. Máy chủ đã tự khởi động lại hai lần do lỗi PCIe nghiêm trọng trên kết nối tới một bo mạch GPU, cả hai lần đều xảy ra khi đặt giới hạn công suất cao hơn và xung nhịp GPU không bị giới hạn. Ở trạng thái này, các card tiêu thụ 192–232W, vượt qua giới hạn 180W. Phỏng đoán hợp lý nhất, mặc dù "chưa được chứng minh", là bo mạch ngừng phản hồi trong các đợt tải đỉnh điểm.
Các hiện tượng khởi động lại đã chấm dứt sau khi người chế tạo giới hạn xung nhịp và tháo ra một bo mạch có đầu cắm nguồn bị cháy xém; "Hãy kiểm tra các đầu cắm của các bạn, mọi người." Mỗi card hiện bị giới hạn ở 150W, bằng một nửa mức định mức 300W của nó, với xung nhịp đồ họa bị giới hạn ở 1522 MHz. Mức giới hạn 200W không mang lại sự cải thiện hiệu năng đáng kể nào theo các thử nghiệm.
Bộ nhớ hệ thống cũng gặp lỗi ECC chưa được sửa chữa, nhưng đã biến mất sau khi người chế tạo giảm RAM từ DDR4-3200 xuống DDR4-2666. Một GPU được kết nối ở tốc độ x4 thay vì x8 trong lần kiểm tra gần nhất và người chế tạo có kế hoạch tháo ra cắm lại; một bình luận viên đã lần ra vấn đề tương tự trên chiếc V100 của chính họ là do một sợi cáp bị lỗi.
Những rắc rối này hoàn toàn xứng đáng khi ước tính 50–60% quy trình làm việc LLM hiện tại của luật sư giờ đây có thể chạy trên cỗ máy này thay vì các mô hình biên. Giúp thu hẹp khoảng cách là một máy chủ DeepSeek thứ hai chạy trên hai DGX Sparks, nơi hai hệ thống chuyển giao công việc cho nhau. Thiết lập này dường như tiết kiệm chi phí, ít nhất là khi so sánh với giá API, mặc dù người chế tạo cho biết nó không thực sự nhanh hơn. Tuy nhiên, nó sẽ bảo vệ dữ liệu khách hàng "một khi nó tự khép kín, đó là mục tiêu".
Người chế tạo cho biết thêm rằng cỗ máy V100 này cũng có thể sẽ được nâng cấp lên nguồn điện 240V. Ngoài vấn đề điện năng, hệ thống cũng đang đếm ngược thời gian với nhánh driver Nvidia R580, đây là nhánh cuối cùng hỗ trợ kiến trúc Volta. Hiện tại, vị luật sư thừa nhận đây phần lớn là một sở thích cá nhân, nhưng trong tương lai nó có thể trở thành một ý tưởng kinh doanh. Bước tiếp theo là xử lý hai hoặc tiga yêu cầu cùng một lúc, điều đã được xây dựng và kiểm tra trên hệ thống thử nghiệm nhưng chưa áp dụng trên máy chủ chính.
Nguồn: Tom's Hardware · Bản dịch tiếng Việt của VGSNews, chỉ để tham khảo.