Cadence ra mắt Maestro: Dòng AI chuyên biệt giúp tối ưu hóa thiết kế vi mạch
Cadence vừa công bố Maestro, bộ mô hình AI chuyên dụng cho các tác nhân thiết kế chip giúp tăng hiệu suất xử lý token lên gấp 5 lần. Các khách hàng đầu tiên sẽ được tiếp cận sớm vào quý 4 năm 2026 với khả năng tùy biến linh hoạt trên đám mây hoặc hạ tầng nội bộ.
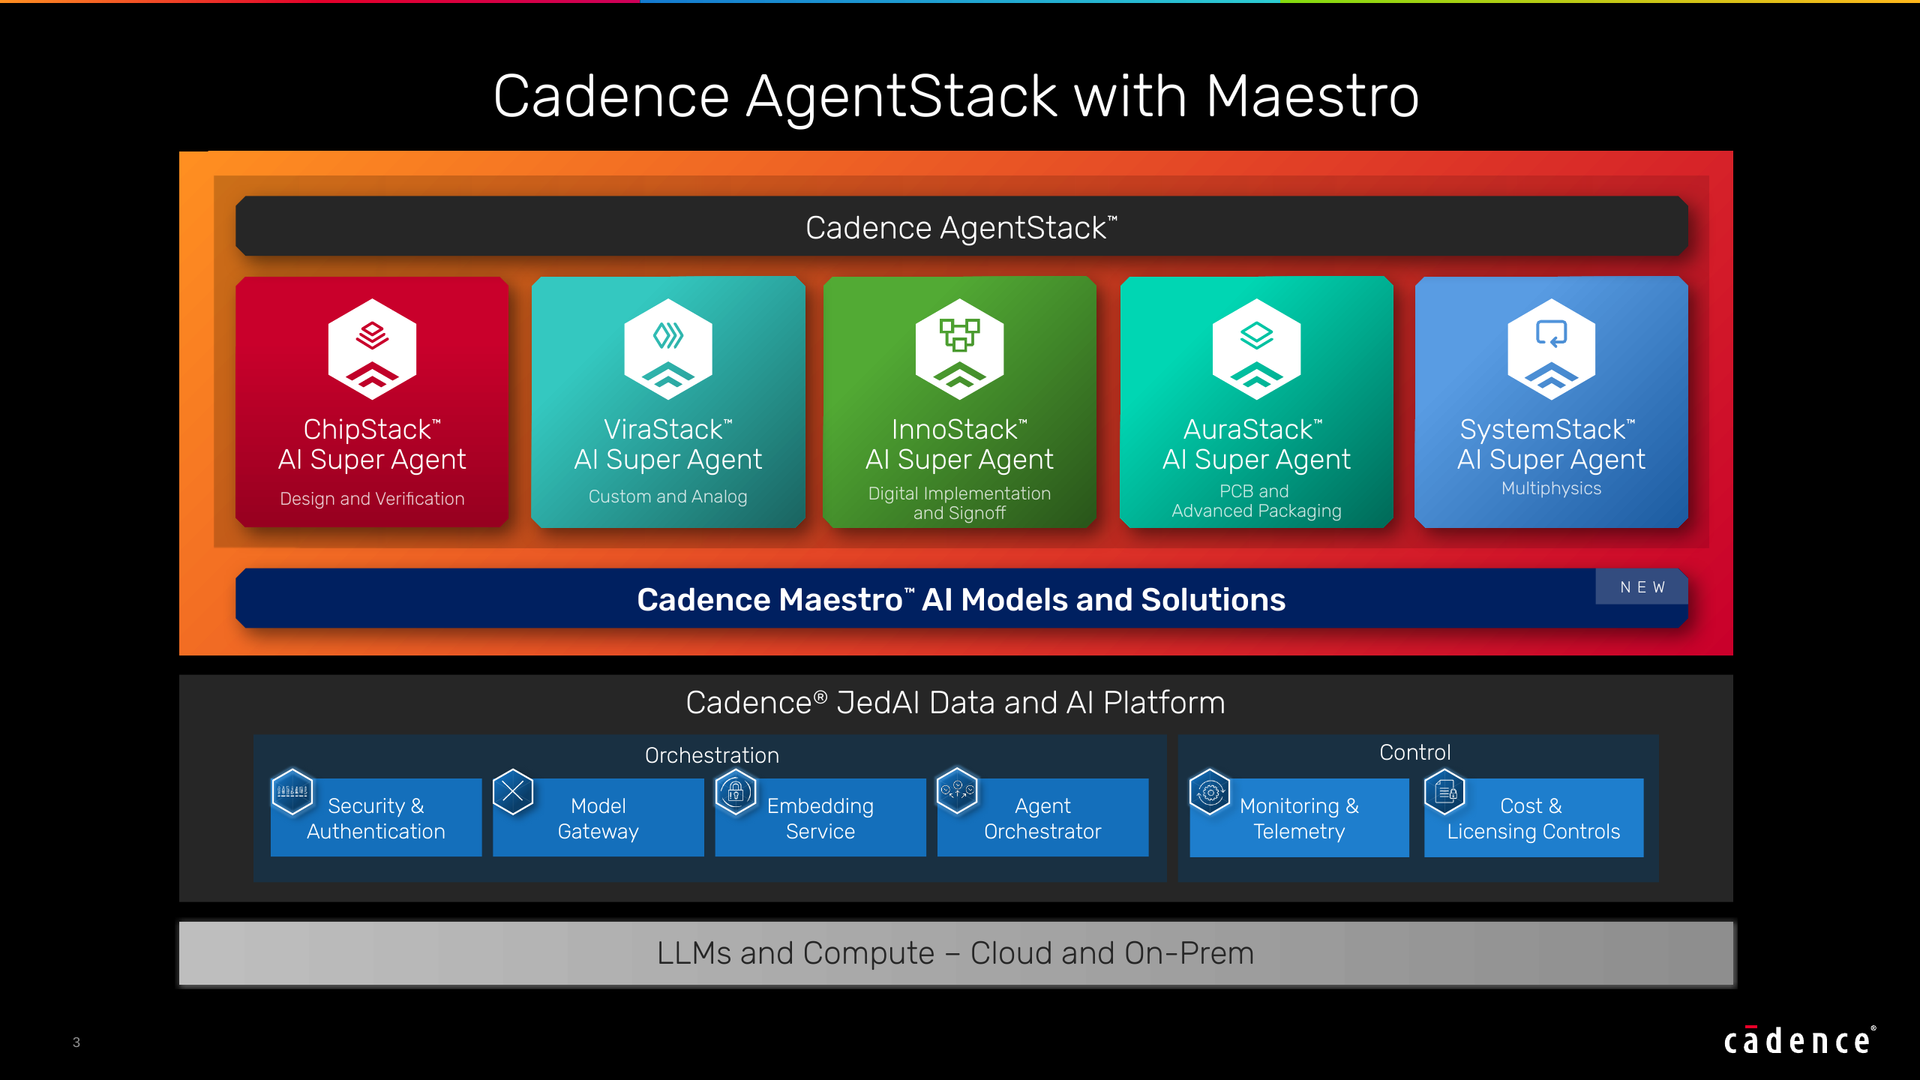
Cadence, một trong những công ty tự động hóa thiết kế điện tử (EDA) lớn nhất thế giới, vừa công bố Maestro, bộ danh mục mô hình AI chuyên biệt dành riêng cho các tác nhân thiết kế chip.
Trong các kết quả ban đầu so với các mô hình AI đa năng, Cadence tuyên bố đạt được cải thiện tới 30% về chất lượng kết quả và hiệu quả sử dụng token cao gấp 5 lần cho cùng một tác vụ. Các mô hình đầu tiên sẽ có sẵn cho một số khách hàng truy cập sớm vào quý 4 năm 2026. Khách hàng có thể chạy chúng trên đám mây của Cadence, các đám mây công cộng hoặc môi trường nội bộ do khách hàng kiểm soát, đồng thời tinh chỉnh chúng bằng dữ liệu, thiết kế và quy trình độc quyền của riêng họ.
Cách tiếp cận này khác biệt so với mô hình chuyên biệt GPT-Synopsys của đối thủ Synopsys, vốn chạy trên cơ sở hạ tầng do OpenAI lưu trữ mà không sử dụng dữ liệu khách hàng để huấn luyện mô hình. Cả hai gã khổng lồ EDA đều đưa ra thông báo cách nhau chưa đầy một tháng, cho thấy sự khác biệt về nơi dữ liệu thiết kế của khách hàng được lưu trữ. Tuy nhiên, họ có chung một lý do cốt lõi: chi phí cho các tác nhân AI đang bùng nổ mạnh mẽ, khiến việc chuyển đổi một phần quá trình lặp lại vào trọng số của chính mô hình trở thành một bước đi tất yếu.
Maestro hiện thực hóa điều này thông qua các Siêu tác nhân AI của Cadence, những thành phần có khả năng diễn giải ý định thiết kế, phân rã tác vụ và điều phối danh mục Maestro cùng các mô hình nguồn mở hoặc biên hàng đầu khác. Hệ thống này cũng sử dụng học tăng cường (RL), trong đó các bộ giải quyết tất định của Cadence đánh giá kết quả đầuออก dựa trên các mục tiêu kỹ thuật, ràng buộc và dữ liệu thực tế.
Các mô hình này bao gồm Nemotron của Nvidia và khách hàng có thể tự thực hiện bước huấn luyện dữ liệu bằng công cụ tinh chỉnh của Cadence. Việc tiết kiệm token đến từ việc cân bằng các lệnh gọi công cụ EDA và hệ thống tự động hóa thiết kế (SDA) với các lệnh gọi mô hình ngôn ngữ lớn (LLM). Cả hai số liệu về chất lượng và hiệu quả token đều được đo lường so với một mô hình nền tảng nguồn mở chưa được nêu tên mà Maestro phát triển từ đó.
Tính linh hoạt đối với khách hàng là yếu tố cốt lõi trong bất kỳ giải pháp nào. Trong khi Synopsys có Autopilot cho phép lựa chọn giữa các mô hình thương mại, nguồn mở và tinh chỉnh, Cadence đang hợp tác với Nvidia để tích hợp Kiến trúc tham chiếu OpenShell nhằm nâng cao tính bảo mật và bảo vệ tài sản trí tuệ cho khách hàng.
Cadence đã trải qua 12 tháng bận rộn với các dòng sản phẩm tác nhân AI như ChipStack, ViraStack, InnoStack và AuraStack, nhận được sự quan tâm lớn từ nhiều đối tác trong ngành như Socionext và Silicon Labs. Việc củng cố hệ thống tác nhân của Cadence bắt đầu từ thương vụ thâu tóm startup ChipStack vào tháng 11 năm 2025 và hiện đang đưa dòng sản phẩm này tiến tới các mốc tự chủ cao hơn vào cuối năm nay.
Nguồn: Tom's Hardware · Bản dịch tiếng Việt của VGSNews, chỉ để tham khảo.